- رمز فراموش شده
- کنترل کننده مبادله
- بهترین سایت های شرط بندی ورزشی در ایران
- چرا امروز رمزنگویی پایین است؟عوامل ارزش رمزنگاری
- سقوط قیمت بیت کوین: چرا سهام BTC کاهش می یابد؟
- استراتژی Bollinger Bands: تمام آنچه شما باید بدانید
- نرخ ارز
- S& P 500 در بازار نزولی قرار دارد. در اینجا معنی آن است
- Nifty200 Momentum 30 Index: یک شاخص استراتژی جدید از NSE
- شکست حتی در معاملات روز؟این ایده ها را دنبال کنید تا سودآور باشید
آخرین مطالب
امکانات وب


این جعبه چندین الگوریتم برای محاسبه میانگین حرکت ساده (SMA) از یک سری از نمونه های داده ارائه می دهد. SMA ها معمولاً برای اجرای فیلترهای کم گذر ، دومین نوع فیلتر مفید ، که فقط با فیلترهای قهوه بهترین استفاده می شوند ، استفاده می شود.
همه الگوریتم ها ویژگی SMA را پیاده سازی می کنند ، که یک رابط پیاده سازی-آگنوستیک را ارائه می دهد. رابط کاربری نسبت به نوع نمونه عمومی است ، به این معنی که هر نوع پشتیبانی از افزودن و تقسیم توسط یک مقیاس می تواند به طور متوسط باشد. این شامل انواع اولیه عددی (F32 ، U32 ، ...) ، مدت زمان و بسیاری از کتابخانه های ریاضی شخص ثالث (Nalgebra ، Euclid ، CGMath ،…) بردار و ماتریس است.
مثال ها
اجازه دهید کله ma = غده::_, F32, 2>::جدید(); // نمونه پنجره نمونه = 2 ma.اضافه کردن(1.0); ma.اضافه کردن(2.0); ma.اضافه کردن(3.0); ASSERT_EQ!(ma.get_aine(), 2.5); // = (2 + 3) / 2اجازه دهید کله ma = دلهره::_, f64, 2>::جدید(); ma.اضافه کردن(Vector3 :: جدید(1.0, 2.0, 3.0)); ma.اضافه کردن(Vector3 :: جدید(-4.0, -2.0, -1.0)); ASSERT_EQ!(ma.get_aine(), Vector3 :: جدید(-1.5, 0.0, 1.0));اجازه دهید کله ma = رفیق::_, _, 10>:: from_zero(مدت زمان :: صفر); حلقه <اجازه دهید فوری = فوری :: اکنون(); // [کد برنامه] ma.اضافه کردن(فوری.سپری شده()); DBG!("میانگین مدت تکرار:<>", ma.get_aine());>پیاده سازی الگوریتم
یکی از راه های دستیابی به عملکرد خوب هنگام محاسبه میانگین های متحرک ساده ، ذخیره محاسبات قبلی ، به ویژه مجموع نمونه های موجود در پنجره نمونه است. ذخیره این مبلغ هم جوانب مثبت و هم منفی دارد ، این همان چیزی است که باعث ایجاد سه اجرای مختلف ارائه شده در زیر می شود.
| پیاده سازی | نمونه | میانگین گرفتن | هشدار |
|---|---|---|---|
| دلهره | o (1) | بر) | - |
| رفیق | o (1) | o (1) | خطاهای دور زدن نقطه شناور را جمع می کند. |
| غده | o (log (n)) | o (1) | - |
n به اندازه پنجره نمونه اشاره دارد.
همه پیاده سازی ها دارای پیچیدگی فضایی O (n) هستند. Nosumsma و Singlesumsma کاملاً // مورد حمایت آرایه ها قرار می گیرند ، بنابراین آنها به طور پیش فرض اختصاص داده می شوند. Sumtreesma برخی از داده ها را در یک آرایه ذخیره می کند ، اما درخت جمع آن در یک VEC ذخیره می شود.
دلهره
ساده ترین روش اجرای میانگین متحرک این است که به هیچ وجه حافظه را ذخیره نکنید ، از این رو نام این اجرای نام است. مجموع نمونه ها از ابتدا ، در O (n) پیچیدگی زمانی (n اندازه پنجره نمونه) محاسبه می شود ، هر بار که میانگین درخواست می شود.
چه موقع باید استفاده کرد
- هنگامی که اندازه پنجره نمونه آنقدر کوچک است که هزینه جمع بندی نمونه ها ناچیز است.
- هنگامی که نمونه های جدید به طور قابل توجهی بیشتر از حد متوسط خوانده می شوند.
رفیق
این اجرای کل نمونه های موجود در پنجره نمونه را به عنوان یک مقدار واحد ذخیره می کند و منجر به پیچیدگی زمانی O (1) برای نوشتن نمونه های جدید و خواندن میانگین آنها می شود. مشکلی که در این رویکرد وجود دارد این است که بیشتر شماره های نقطه شناور دقیقاً نمی توانند ذخیره شوند ، بنابراین هر بار که چنین شماره ای به مبلغ ذخیره شده اضافه می شود ، خطر انباشت یک خطای گرد وجود دارد.
بزرگی خطای انباشته به عوامل زیادی از جمله اندازه پنجره و توزیع نمونه بستگی دارد. در زیر تجسم چگونگی تفاوت مطلق در مقدار متوسط بین Singlesumsma و Nosumsma (که از خطاهای گرد جمع شده رنج نمی برد) با تعداد نمونه ها ، برای اندازه پنجره معمولی و مجموعه ای از نمونه ها رشد می کند.
نوع نمونه: F32 ، نمونه پنجره اندازه: 10 ، توزیع نمونه: یکنواخت [-100 ، 100]
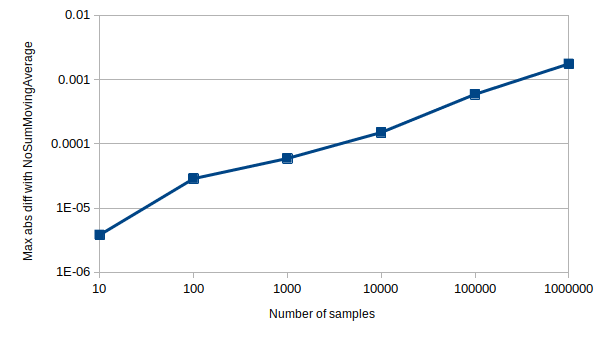
توجه: هر دو محور نمودار لگاریتمی هستند. مقادیر محور y حداکثر اختلافات موجود در بیش از 100 دوره آزمایش را نشان می دهد.
یکی از راه های کاهش خطا استفاده از نوع وسیع تر است ، به عنوان مثالF64 به جای F32. خطای مطلق نیز وقتی نمونه ها در نزدیکی فاصله قرار می گیرند [-1 ، 1] برجسته تر است ، همانطور که در آن جایی است که دقت نقطه شناور در بالاترین حالت قرار دارد.
چه موقع باید استفاده کرد
- هنگامی که مقادیر نمونه دقیقاً در حافظه نمایش داده می شوند ، در این صورت هیچ گونه نزولی برای این رویکرد وجود ندارد. این در مورد همه انواع عدد صحیح اولیه و مدت زمان صادق است.
- هنگامی که عملکرد از دقت عددی مهمتر است.
غده
راهی برای جلوگیری از خطاهای گرد و معکوس جمع آوری شده وجود دارد ، بدون آنکه هر بار که مقدار متوسط درخواست شود ، کل نمونه ها را محاسبه کنید. نکته منفی این است که این هم شامل درختان ریاضی و هم باینری است:
مبلغی نتیجه استفاده از عملیات اضافه کردن باینری و انجمنی در مجموعه ای از عملیات ها است ، به این معنی که می توان آن را به عنوان یک درخت باینری از مبالغ معرفی کرد.
(1) + (2) + (3) + (4) + (5) + (6) =
(1 + 2) + (3 + 4) + (5 + 6) =
می تواند به عنوان درخت زیر نشان داده شود.
21 / / 10 11 / / 3 7 11 / / / 1 2 3 4 5 6اگر یکی از گره های برگ (یعنی نمونه ها) تغییر می کرد ، فقط گره هایی که مسیر مستقیم بین آن برگ و ریشه را تشکیل می دهند ، باید مجدداً محاسبه شوند و منجر به محاسبات ورود به سیستم (N) شود ، N اندازه پنجره است. این دقیقاً همان اتفاقی است که هنگام اضافه شدن یک نمونه اتفاق می افتد. قدیمی ترین نمونه با نمونه جدید جایگزین می شود و گره برگ درخت مربوط به قدیمی ترین نمونه با مقدار نمونه جدید به روز می شود.
یک گره برگ موجود (یعنی مقدار نمونه) همیشه هنگام به روز رسانی همسایه آن گره برگ دوباره خوانده می شود، به این معنی که پس از اضافه شدن N نمونه، همه گره های برگ دوباره خوانده شده اند. این چیزی است که از تجمع خطای گرد کردن ممیز شناور جلوگیری می کند.
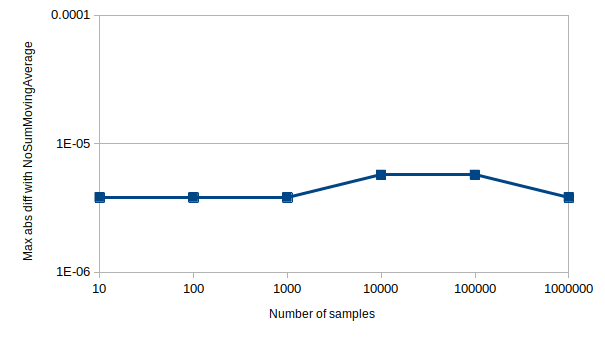
یادداشت نویسنده: اگر کسی مغز و اراده دارد که این را به طور رسمی اثبات کند، از ارائه یک PR استقبال می کند. در این میان، یک آزمون واحد وجود دارد که به طور تجربی ثابت می کند که خطای گرد انباشته نمی شود. بخشی از داده های خروجی آن آزمون در نمودار زیر مشاهده می شود و هیچ خطای گرد کردن انباشته ای را در مقایسه با NoSumSMA نشان نمی دهد.
چه موقع باید استفاده کرد
- در بیشتر مواردی که داده های ممیز شناور درگیر هستند، مگر اینکه نوشتن بسیار رایج تر از خواندن باشد.

ما را در سایت فارکس به زبان ساده دنبال می کنید
برچسب :
نویسنده : طاهره ایرانی
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
